📓 Archive

  • Pricing
  • Billiards
  • Chess
  • Syntax
  • 2026-11-02 05:02:07.994049708 +0800 CST m=+5.963751363
    SQUIRREL

    FGJ: Create:2024/09/26 Update: (2026-10-11)

    • Intro(RIME | SQUIRREL | 自定义输入法) #

      Caution

      因为需要输入法配置灵活度高,所以找到开源的鼠须管,基于中州韵输入法引擎的一个 macosx 端实现。 详细介绍(自序、历史、概念、项目构成、开发计划)
      另外本文主要针对 【朙月拼音】 和 【小鹤双拼】 等方案进行配置,当然其他方案也可以局部参考。

      贴一些使用过程中的感受:
      1. 好用是真好用,但是学习成本是真 TM 高。如果只是想简单使用,默认配置基本够用。如果想打造成满心欢喜的神兵利器,还是需要时间滋养的。可以循序渐进。
      2. 官方的概念多且杂,但是还又不能不看,建议有个全局了解。这样碰见其他人分享的配置文件,也能看个大概,汲取精华,去其糟粕。因为外部资料更是一搜一大堆。
      3. 因为这东西大概在 11 年左右出来的,出道早,以至于滋生出各式各样的输入法编码,完备方案等,不懂大概运行流程及配置关系只会懵逼树下懵逼果,偷鸡的话只能祈求上天保佑好使了。

      • 下载安装 #

        下载页面, macOS 鼠须管 1.0.2 pkg 安装包(属于将引擎中州韵代码作为 git 子模块,编译成动态链接库供鼠须管使用)

        macOS 编译指南
        鼠鬚管 Wiki

        重新部署: 参考
        /Library/Input\ Methods/Squirrel.app/Contents/MacOS/Squirrel --reload
        control + option + .

      • 配置 #

      • 朙月拼音【自定义及解释】 #

        外观相关参数 #

        可以将输入法展示区块分为三部分:inline(目标区),preedit(编辑区)[可消失],candidate(候选区)[不消失]
        inline_preedit__:编辑区与目标区行内显示(简单理解为编辑区覆盖目标区)
        inline_candidate:候选区与目标区行内显示(简单理解为候选区覆盖目标区)
        同时覆盖的话,编辑区消失,候选区上位,

        分隔符修改 #

        修改拼写分隔符: luna_pinyin.custom.yaml。由原来的delimiter: " '" 到 delimiter: "'"
        speller/delimiter:引用(RimeWithSchemata / 【三】最高武藝)中的注释:隔音符號用「’」;第一位的空白用來自動插入到音節邊界處。
        翻译过来就是可以手动通过第二位对拼音进行分割,比如西安这个的拼音xi'an,就可以手动打',其余自动分割的用第一个符号。
        改完后delimiter: "'"的一二位因为一样,所以使用一个就可以了。

        翻页配置 #

        修改翻页为-|=: 预定义。
        在位置default.custom.yaml,key_binder: 增加两个 bindings (结果没生效)
        { when: paging, accept: minus, send: Page_Up}
        { when: has_menu, accept: equal, send: Page_Down}
        大意了,原来预置的key_bindings.yaml里买就有相关快捷键的定义,但是自己手贱,又重新在default.custom.yaml里面重新定义了,并且没有绑定相关键位,发现不生效,以为原来的预置的键位没有绑定上去。其实应该是在 custom 文件里面进行追加或者修改的,不是直接定义(会覆盖)。

        例如:右边default.custom.yaml代码中追加和修改示例。

        # encoding: utf-8
        
        patch:
            # append
            key_binder/+:
                bindings/+:
                    - { when: has_menu, accept: at, send: 'm' }
        
            # update
            key_binder/bindings/@0:
                { when: has_menu, accept: minus, send: Print }
        

        修改插入记号(CARET) #

        修改 caret (插入记号,也叫脱字符):符号‸,此处的符号引用自 UI Improvements / 10。
        查看 librime 引擎中相关代码,发现在 此处 使用了|模拟了插入记号,所以感觉应该是在每个客户端(squirrel|weasel)中去自自己实现的。然后转到 squirrel,在 此处 SquirrelInputController.swift 发现相关代码,其中 caretPos 就是指定了位置,但是并没有看出来是怎么使用的,比如是直接将插入符号追加到编辑区 还是 在后续调用中根据位置直接设置的。swift 代码不太好看,无从下手了,所以没有解决。在此处仅做个记录。😝

        更新上述错误表述:后面查看代码的时候发现在 librime 引擎处有 kCaretSymbol 定义,而且在下面一行处有用户可配置的选项soft_cursor,大概熟悉代码后发现这只是一个开关(false|true),用来控制是否显示插入符号的开关,通过 debug 验证后发现可行。于是添加如下图括起来的类似配置,在本地进行测试,发现在 Squirrel 端并不生效。于是查看 squirrel 端代码,发现有 这样的判断,进而对soft_cursor进行了覆写,所以没生效。但是根据它的判断条件也可以进行验证,一般对于浏览器,都是进行强制内联(inline)的。所以在浏览器地址栏输入就不会出现插入符号了。


        接着,为了实现修改插入记号的初始想法,就必须修改引擎代码然后重新编译出动态链接库,替换 squirrel 自己编译出来的。步骤如下:
        1).: 修改 kCaretSymbol 定义 中 38 行代码为:static const string kCaretSymbol("\xe2\x86\x9e");,\xe2\x86\x9e就是你想替换的任何 UTF-8 符号的十六进制编码。比如我此处的就是↞。
        2).: 此处使用 clion + camke 的方式编译出动态链接库/path/librime/cmake-build-release/lib/librime.1.11.2.dylib
        3).: 进入 squirrel 输入法目录:cd /Library/Input Methods/Squirrel.app/Contents/Frameworks
        4).: 备份 squirrel 自带(或它附带编译出来)的:sudo mv librime.1.dylib librime.1.dylib.bak
        5).: 使用刚才编译出的进行替换:sudo cp /path/librime/cmake-build-release/lib/librime.1.11.2.dylib librime.1.dylib
        6).: 重启输入法进行验证:/Library/Input\ Methods/Squirrel.app/Contents/MacOS/Squirrel --quit,过一会自己就启动了。

        如果需要此次编译出来 macOS 端的动态链接库librime.1.11.2.dylib, 点击下载。
        需要注意的是:
        a).: 这次编译出来的 Release 版本大小为3.4M,原来的为7.0M,不知道什么区别,仅供测试。(后来发现跟插件有关系,比如 lua)
        b).: 浏览器中编辑框中最后的那个竖线|是闪动的光标,正好闪动的时候截的图。

        添加LUA脚本 #

        lua脚本使用,直接输入日期之类的
        使用方法:
        a).: 在用户配置目录~/Library/Rime/新建文件rime.lua,里面的内容 参考 hchunhui/librime-lua/wiki
        b).: 在luna_pinyin.custom.yaml中添加 engine/translators/@before 0/: lua_translator@date_translator, 启用 lua 日期翻译器。效果如下左 gif。

        但是这样的话,自己编译的librime.1.11.2.dylib里面没有启用插件,需要将插件编译进去,编译过程如下:
        1).: 目前 rime 生态体系支持的插件有 这些 plugins
        2).: 如果想要安装某个插件,比如hchunhui/librime-lua,进入到源码目录 librime ,在终端执行./install-plugins.sh hchunhui/librime-lua。会将插件仓库下载到当前目录的plugins中。
        其他插件类似,但是hchunhui/librime-lua,这个插件的 CMakeLists.txt 第五行有点问题,我本地是有 lua-5.4.6 的,但是它没检测到,将lua54 改成lua5.4即可通过重建 cmake 工程。
        3).: 将 clion 切换到 Release profile, 重新 build 即可重新生成 cmake-build-release/lib/librime.1.11.2.dylib。
        4).: 如上 修改插入记号CARET 的操作,复制替换重启一气呵成。效果如下右 gif。

        如果需要此次编译出来 macOS 端的动态链接库2ed-librime.1.11.2.dylib, 点击下载。

        添加词库 #

        添加搜狗 网络, 计算机 等相关词库。并使用在线工具 词库转换器,将 scel 文件转换成 txt,比如:网络流行新词【官方推荐】.txt 、计算机词汇大全【官方推荐】.txt

        秉承不修改 Shared 目录文件的原则,通过给luna_pinyin.schema.yaml打补丁,修改translator/dictionary 的值。
        具体操作如下:
        1).: 将 Shared 目录 /Library/Input\ Methods/Squirrel.app/Contents/SharedSupport/ 中的luna_pinyin.dict.yaml复制一份到用户目录 ~/Library/Rime/ ,并改名为luna_pinyin_compact.dict.yaml。
        2).: 编辑luna_pinyin_compact.dict.yaml,在 use_preset_vocabulary 一行后面添加import_tables: [ sougou_pinyin_network, sougou_pinyin_computer ]
        3).: 新建文件sougou_pinyin_network.dict.yaml,先写入如下模板头,剩下的通过命令将 txt 内容追加到后面即可。计算机同样的方式。
        4).: 导入命令:cat /path/网络流行新词【官方推荐】.txt >> sougou_pinyin_network.dict.yaml
        5).: 将原来luna_pinyin.schema.yaml中定义的translator/dictionary: luna_pinyin 通过打补丁的方式替换,这样明月拼音相关方案中的词典都会替换。
        补丁方法:在luna_pinyin.custom.yaml添加内容补丁:translator/dictionary: luna_pinyin_compact
        卸载词库也很简单,只需要将补丁行translator/dictionary: luna_pinyin_compact注释即可,这样原来的就会起作用。
        词库去重部分暂时没处理。另外还有 这样: issues/214 的问题

        # luna_pinyin_compact.dict.yaml
        
        # Rime dictionary
        # encoding: utf-8
        #
        
        ---
        name: luna_pinyin_compact
        version: "2024.10.06"
        sort: by_weight
        use_preset_vocabulary: true
        import_tables: [ sougou_pinyin_network, sougou_pinyin_computer ]
        ...
        
        〇  ling
        ㄓ  zhi
        ㄔ  chi
        ㄕ  shi
        ㄖ  ri
        # ...
        
        # sougou_pinyin_network.dict.yaml
        
        # Rime dictionary
        # encoding: utf-8
        #
        
        ---
        name: sougou_pinyin_network
        version: "2024.10.06"
        sort: by_weight
        use_preset_vocabulary: true
        ...
        
        阿拜多斯
        阿贝贝
        阿贝多
        阿策
        阿蝉
        啊对对对
        # ...
        
        # sougou_pinyin_computer.dict.yaml
        
        # Rime dictionary
        # encoding: utf-8
        #
        
        ---
        name: sougou_pinyin_computer
        version: "2024.10.06"
        sort: by_weight
        use_preset_vocabulary: true
        ...
        
        阿姆达尔定律
        阿帕网
        埃尔布朗基
        埃尔米特函数
        埃克特
        艾丽莎病毒
        # ...
        

        中英混输 #

        要想在中文模式下输入英文单词,有一种办法就是将输入的编码 通过自定义的 table 类型的英文翻译器进行转换,只需要进行相关的配置就行。

        具体操作如下:
        1).: 先生成字典配置en_dict.dict.yaml如右所示,网上下载这两个码表 en.dict.yaml(主表)、 en_ext.dict.yaml(扩展表)。
        重命名en.dict.yaml ==> en_primary.dict.yaml
        2).: 配置自定义文件luna_pinyin.custom.yaml,新增英文翻译器(table_translator@english),主要配置如右。
        还有一个默认的主翻译器,稍后要进行调频,所以一起配置了。
        3).: 进行调频,其实就是给两个翻译器配置中的initial_quality进行赋值,参数可以 参考:优化 Rime 英文输入体验/权重设定
        4).: 重新部署,如果没问题,日志没报错,那就是没问题了,直接输入体验就行。
        但是我的日志报错:Error loading table for dictionary 'en_dict'.
        5).: 解决方式就是暂时将我们的en_dict配置给主翻译器,让生成 *.bin 词典数据后,再换回来。
        5.1).互换右边第 4 和 17 行。
        5.2).重新部署一次,让生成 bin 文件,如果成功的话会在用户目录下 build 文件夹生成 **en_dict.***等文件。
        5.3).互换右边第 17 和 4 行。
        5.4).再次重新部署就没问题了。

        # en_dict.dict.yaml
        
        # Rime dictionary (encoding: utf-8)
        
        ---
        name: en_dict
        version: "2024.10.06"
        sort: by_weight
        use_preset_vocabulary: true
        import_tables: [ en_primary, en_ext ]
        ...
        
        
        patch:
        
            engine/translators/@before 2/: table_translator@english
            english:
                dictionary: en_dict
                # spelling_hints: 9
                # max_phrase_length: 4
                #enable_completion: false
                #enable_sentence: false
                #initial_quality: -0.5
                enable_sentence: false
                enable_user_dict: false
                initial_quality: 1.1
                comment_format:
                    - xform/~(.*)/\[$1\]/
        
            translator:
                dictionary: luna_pinyin_compact
                initial_quality: 1.2
        

        中英自动添加空格 #

        想要实现在中西文中间自动加入空格的这种功能,官方在引擎部分可能不打算实现了,参考 issues:24。不过我们可以借助 Lua 脚本辅助解决一下,虽然不是那么完美,但对于我来说,够了。
        对于实现部分,照猫画虎,参照 issues:238 实现思路,以及 aux_code.lua 语法中通知部分。最后实现的 append_space.lua 如下折叠的 Lua 脚本。

        大致思路是:通过 通知功能 将上一次上屏的内容类型记录在 rime 的某个环境变量中,供后续判断使用。然后针对当前输入所带出来的每个候选项进行过滤,逐个匹配看是否要添加空格(也就是修改候选项)。比如输入完你好上屏之后,此时给 prior_commit_type 环境变量赋值 1 表示上一段是中文,紧接着下次输入hello候选项里面有英文单词,短语之类的话,就替换为前置空格的候选项。相应的,如果输入其他符号,则将 变量置为 0,表示不需要转换。

        Caution

        1:因为状态判断是存在引擎环境变量中,没有很好的时机去重置,所以如果不是相邻的地方也会存在影响。
        比如第一行输入你好了,然后在第二行输入hello 也会出现空格(vscode 会自己忽略,挺好,😆)。
        2:目前只处理候选项,不会对 preedit 进行干预。

        patch:
            # ...
            engine/translators/@before 5/: table_translator@english
            engine/filters/+: 
                - lua_filter@*aux_code@flypy_full
                - lua_filter@*append_space
            # ...
        
        Lua 脚本
        -- https://github.com/boomker/rime-fast-xhup/blob/b3700709aa12e44d13970ac49936688204f0e99c/lua/word_append_space.lua
        
        local ASpaceFilter = {}
        -- local log = require 'log'
        -- log.outfile = "/tmp/space_code.log"
        
        function ASpaceFilter.is_chinese_phrase(input)
            if not input or #input == 0 then return false end
            local last_codepoint = nil
            for _, codepoint in utf8.codes(input) do last_codepoint = codepoint end
            if last_codepoint >= 19968 and last_codepoint <= 40959 then return true end
            return false
        end
        
        function ASpaceFilter.distinguish_text_type(input)
            if ASpaceFilter.is_chinese_phrase(input) then return 1 end
            if string.match(input, "^[%w%s]+$") ~= nil then return 2 end
            return 0
        end
        
        function ASpaceFilter.init(env)
            local engine = env.engine
            local config = engine.schema.config
            env.prior_commit_type = 0;
            env.commit_notifier = engine.context.commit_notifier:connect(function(ctx)
                -- local preedit = ctx:get_preedit()
                -- local is_cn = ASpaceFilter.is_chinese_phrase(ctx:get_commit_text())
                -- log.info('commit_notifier', ctx:get_commit_text(), preedit.text, is_cn)
                env.prior_commit_type = ASpaceFilter.distinguish_text_type(ctx:get_commit_text())
                -- log.info('env.commit_type', env.prior_commit_type)
            end)
        end
        
        function ASpaceFilter.func(input, env)
            for cand in input:iter() do
                -- log.info("xxxxxxxxx", env.prior_commit_type, type)
                if env.prior_commit_type == 1.0 or env.prior_commit_type == 2.0 then
                    local type = ASpaceFilter.distinguish_text_type(cand.text)
                    if (env.prior_commit_type == 1.0 and type == 2.0) or (env.prior_commit_type == 2.0 and type == 1.0) then
                        cand = ShadowCandidate(cand:get_genuine(), cand.type, " " .. cand.text, cand.comment)
                    end
                end
                yield(cand)
            end
        end
        
        function ASpaceFilter.fini(env)
            env.commit_notifier:disconnect()
        end
        
        return ASpaceFilter
        

        反查配置 #

        在查资料的过程中,发现有其他配置文件中比较喜欢反查,于是查了一下 【反查】的意思:大概就是使用其他方案来解释当前的输入,比如当前要是使用朙月拼音输入法的话,输入特定的反查前缀触发后续匹配,比如要用笔画字典中的值(㐀 shhsh),假设前缀为Ub,则输入码为Ubshhsh的话,就可以打出来【㐀】字了。

        处理流程:
        1. 先是 matcher 分段器结合配合 recognizer 中 patterns 所定义的正则对应的值为后续的输入打上标签。
        2. 然后此类标签段由 reverse_lookup_translator 或者reverse_lookup_translator@xxx 翻译器根据指定的字典进行查询翻译,返回候选词在候选框。

        注意事项 
        1. 配置反查可以有其他实现方案。
        2. 目前配置了两种反查,一种是笔画(横竖撇捺折),另一种是拆字(三木为森)。默认的配置给了 stroke(笔画),新增一个 reverse_lookup_translator@radical_reverse_lookup 用于 拆字。
        3. 且都已大写字母U开头,笔画是Ub,拆字是Uc。所以需要在 speller/alphabet 中将大写字母加进去,不然输入大写字母可能就流产了,另一个好处是可以翻译大写字母开头的单词。
        4. 避免默认的大写匹配,感觉这种没卵用,就覆盖了。recognizer/patterns/uppercase: ""
        5. 下方演示中的 Ub 因为有配置preedit_format: [ "xlit/hspnz/一丨丿丶乙/"] 这样的转换,所以输入的 shhsh 变为了 【丨一 一 丨 一】。

        参考资料:
        https://github.com/mirtlecn/rime-radical-pinyin
        https://www.mintimate.cc/zh/demo/reverseWords.html

        可以参考的完整补丁配置
        patch:
        
            # hello 是扩展的英文词库 en_dict,配置在这儿主要是利用 schema 里面的 translator 可以自动编译词典的特性,
            # 让帮忙编译一下,然后给下面配置的 english/translator 使用,不然它自己编译不了。算是一种折中解决方案。
            schema/dependencies: ['stroke', 'hello', 'radical_pinyin']
        
            switches/@0/reset: 1
            switches/@0/states: ['中', 'A']
            switches/+:
                - { name: soft_cursor, reset: 1 }   # 0 不展示, 1 展示 caret
                - { name: print_segments, reset: 1 }   # 0 不展示, 1 展示 segments
        
            #speller/delimiter: "\"'"
            speller/delimiter: "'"
        
            # 包含大写查表
            speller/alphabet: zyxwvutsrqponmlkjihgfedcbaZYXWVUTSRQPONMLKJIHGFEDCBA
        
            menu/page_size: 5
        
            #engine/segmentors/@before 2/: affix_segmentor@radical_reverse_lookup
        
            engine/translators/@before 0/: lua_translator@date_translator
            engine/translators/@before 4/: reverse_lookup_translator@radical_reverse_lookup
            engine/translators/@before 5/: table_translator@english
            english:
                dictionary: en_dict
                # max_phrase_length: 4
                #enable_completion: false # 是否启用英文输入联想补全
                #enable_sentence: false # 混输时不出现带有图案的英文
                #initial_quality: -0.5 # 英文候选词的位置, 数值越大越靠前。
                enable_sentence: false   # 禁止造句
                enable_user_dict: false  # 禁用用户词典
                initial_quality: 1.1     # 英文权重 1.1
                comment_format: # 自定义提示码
                - xform/~(.*)/\[$1\]/           # 清空提示码(就是没有那个小尾巴)
        
            translator:
                dictionary: luna_pinyin_compact
                initial_quality: 1.2
                enable_completion: true
                always_show_comments: true
                preedit_format:
                - xform/([nl])v/$1ü/            # 将用户输入「nv」、「lv」显示为「nü」、「lü」
                - xform/([nl])ue/$1üe/
                - xform/([jqxy])v/$1u/
                # comment_format:
                #- xform/(.*)/\[$1\]/
        
            # https://github.com/mirtlecn/rime-radical-pinyin
            reverse_lookup:
                comment_format:
                - "xform/([nl])v/$1ü/"
                dictionary: stroke
                enable_completion: true
                preedit_format:
                - "xlit/hspnz/一丨丿丶乙/"
                prefix: Ub
                suffix: "'"
                tips: "〔筆畫〕"
        
            radical_reverse_lookup:
                tag: radical_lookup
                comment_format:
                - "xform/([nl])v/$1ü/"
                dictionary: radical_pinyin
                enable_completion: true
                prefix: Uc
                suffix: "'"
                tips: "〔拆字〕"
        
        
            recognizer/patterns/reverse_lookup: "Ub[a-z]*'?$"
            recognizer/patterns/radical_lookup: "Uc[a-z]*'?$"
            # 避免大写反查
            recognizer/patterns/uppercase: ""
        
            punctuator/import_preset: symbols_updated
        
            editor/bindings/Return: confirm


        辅助码解决方案 #

        辅助码这种技术一般是跟随着双拼出现的,根据出现背景了解到其实是为了解决同音字候选项较多,不能精准定位,需要多次翻页才可以找到的情况。比如在小鹤双拼中vi这个编码可能有好几百个候选词,如何精准定位到某一个就需要辅助码了。比如 【小鹤音形】 就是一种辅助码的形式,采用 音码 + 形码 的方式精准定位。

        所以可以简单理解辅助码为过滤码。知道大概怎么回事儿后,就可以发现其实也可以用于其他各种编码方案,包括我们使用的 朙月拼音。

        目前知道的在 rime 中发挥作用的辅助码有如下两种形式:

        第一个是混合编码: 如 rime-flypy-zrmfast 中所采用的方式
        其实就是将编码已音码]形码的方式硬编码在字典文件 flypy_zrmfast.dict.yaml 中。例如: 智 vi[uo,后面的形码采用的方式是小鹤音形的。( 形码速查网址)
        当用户输入vi的时候,会显示 zhi 音相关词汇,继续输入[uo,会直接匹配到字典表中的智。

        第二个是单独编码(目前所采用的形式): 如 rime-lua-aux-code,使用单独的辅助码字典和 lua 脚本即可完成过滤,而且可以根据情况触发,比较灵活。如下运作过程:
        1. 正常输入过程不会涉及到辅助码,lua 脚本拦截后只是简单传递,并不会对候选项做其他额外的处理(包括过滤和添加提示码等)。
        2. 当输入触发符号;(可配置)的时候,并且继续输入的时候就会发挥作用,将;之后的输入当形码,在单独的辅助码字典中查找并过滤。
        3. 将过滤结果已候选词的形式展示,供用户选择。

        注意事项:
        跟 反查配置 中的 speller/alphabet 一样,需要对上屏字母进行排除,不然流产。

        当前将第二种形式集成到使用的两个方案中,下图展示了分别在 朙月拼音 和 小鹤双拼 中如何根据形码快速定位智。(因为之前输入过,排在前面了,不影响效果,换成其他的也无妨)

        可以参考的完整补丁配置
        patch:
        
            # hello 是扩展的英文词库 en_dict,配置在这儿主要是利用 schema 里面的 translator 可以自动编译词典的特性,
            # 让帮忙编译一下,然后给下面配置的 english/translator 使用,不然它自己编译不了。算是一种折中解决方案。
            # 后期整理到了 en_dict 里面
            schema/dependencies: ['en_dict', 'stroke', 'radical_pinyin']
        
            switches/@0/reset: 1
            switches/@0/states: ['中', 'A']
            switches/+:
                - { name: soft_cursor, reset: 1 }   # 0 不展示, 1 展示 caret
                - { name: print_segments, reset: 1 }   # 0 不展示, 1 展示 segments
        
            #speller/delimiter: "\"'"
            speller/delimiter: "'"
        
            # 呃,倒背字母表完全是個人喜好
            # 包含大写查表
            speller/alphabet: zyxwvutsrqponmlkjihgfedcbaZYXWVUTSRQPONMLKJIHGFEDCBA;
            speller/initials: zyxwvutsrqponmlkjihgfedcbaZYXWVUTSRQPONMLKJIHGFEDCBA
        
            menu/page_size: 5
        
            #engine/segmentors/@before 2/: affix_segmentor@radical_reverse_lookup
        
            engine/translators/@before 0/: lua_translator@*date_translator
            engine/translators/@before 4/: reverse_lookup_translator@radical_reverse_lookup
            engine/translators/@before 5/: table_translator@english
            engine/filters/@next/+: lua_filter@*aux_code@flypy_full
            # engine/filters/@next/+: lua_filter@*aux_code@ZRM_Aux-code_4.3
            english:
                dictionary: en_dict
                # max_phrase_length: 4
                #enable_completion: false # 是否启用英文输入联想补全
                #enable_sentence: false # 混输时不出现带有图案的英文
                #initial_quality: -0.5 # 英文候选词的位置, 数值越大越靠前。
                enable_sentence: false   # 禁止造句
                enable_user_dict: false  # 禁用用户词典
                initial_quality: 1.1     # 英文权重 1.1
                comment_format: # 自定义提示码
                - xform/~(.*)/\[$1\]/           # 清空提示码(就是没有那个小尾巴)
        
            translator:
                dictionary: luna_pinyin_compact
                initial_quality: 1.2
                enable_completion: true
                always_show_comments: true
                # 設定多少字以內候選標註完整帶調拼音,换句话说就是候选项中超过几个字的时候不显示拼音,
                # always_show_comments = true,才行。对于拼音输入发来说好像没什么用,因为我知道怎么打出来的,就不用显示,
                # 如果不知道读音的话,还好,比如,反查之类的。但是反查好像默认会显示。
                # spelling_hints: 1
                preedit_format:
                - xform/([nl])v/$1ü/            # 将用户输入「nv」、「lv」显示为「nü」、「lü」
                - xform/([nl])ue/$1üe/
                - xform/([jqxy])v/$1u/
                # comment_format:
                #- xform/(.*)/\[$1\]/
        
            # https://github.com/mirtlecn/rime-radical-pinyin
            reverse_lookup:
                comment_format:
                - "xform/([nl])v/$1ü/"
                dictionary: stroke
                enable_completion: true
                preedit_format:
                - "xlit/hspnz/一丨丿丶乙/"
                prefix: Ub
                suffix: "'"
                tips: "〔筆畫〕"
        
            radical_reverse_lookup:
                tag: radical_lookup
                comment_format:
                - "xform/([nl])v/$1ü/"
                dictionary: radical_pinyin
                enable_completion: true
                prefix: Uc
                suffix: "'"
                tips: "〔拆字〕"
        
        
            recognizer/patterns/reverse_lookup: "Ub[a-z]*'?$"
            recognizer/patterns/radical_lookup: "Uc[a-z]*'?$"
            # 避免大写反查
            recognizer/patterns/uppercase: ""
        
            punctuator/import_preset: symbols_updated
        
            editor/bindings/Return: confirm
        

        微信表情快捷输入 #

        翻找表情比较麻烦,还不知道什么意思,所以利用输入法配置一下。
        采用自定义符号的形式, 参考:Rime 自定義短語文件樣例
        需要注意:这个是微信功能支持,输入表情格式的文字会转换为对应的表情,和输入法没关系。此处的输入法只是为了将输入liu转化为[666],touxiao转化为[偷笑]等。

        具体操作如下:
        1).: 因为默认配置里面已经写好相关引用了,所以只需要在用户目录下新建custom_phrase.txt文件,将微信表情相关的符号写入到里面就可以了。符号定义如下:
        如果是百度输入法,则可以 参考:baidu输入法个性短语导入

        2026-10-10更新:原来的那种方式,只针对朙月拼音有效,并入主词典后,可以支持小鹤双拼。内容如: luna_pinyin_cp_wechat_emoji.dict

        微信表情自定义符号
        # Rime table
        # coding: utf-8
        #@/db_name  custom_phrase.txt
        #@/db_type	tabledb
        #
        # 用於【朙月拼音】系列輸入方案
        # 【小狼毫】0.9.21 以上
        #
        # 請將該文件以UTF-8編碼保存爲
        # Rime用戶文件夾/custom_phrase.txt
        #
        # 碼表各字段以製表符(Tab)分隔
        # 順序爲:文字、編碼、權重(決定重碼的次序、可選)
        #
        # 雖然文本碼表編輯較爲方便,但不適合導入大量條目
        #
        # no comment
        
        中州韻輸入法引擎	rime	3
        Rime Input Method Engine	rime	2
        http://code.google.com/p/rimeime/	rime	1
        xhsgg12302@126.com 	email
        
        # [微信分组]
        [微笑]	weixiao	10
        [撇嘴]	piezui	10
        [色]	se	10
        [发呆]	fadai	10
        [得意]	deyi	10
        [流泪]	liulei	10
        [害羞]	haixiu	10
        [闭嘴]	bizui	10
        [睡]	shui	10
        [大哭]	daku	10
        
        [尴尬]	ganga	10
        [发怒]	fanu	10
        [调皮]	tiaopi	10
        [呲牙]	ciya	10
        [惊讶]	jingya	10
        [难过]	nanguo	10
        [囧]	jiong	10
        [抓狂]	zhuakuang	10
        [吐]	tu	10
        [偷笑]	touxiao	10
        
        [愉快]	yukuai	10
        [白眼]	baiyan	10
        [傲慢]	aoman	10
        [困]	kun	10
        [惊恐]	jingkong	10
        [憨笑]	hanxiao	10
        [悠闲]	youxian	10
        [咒骂]	zhouma	10
        [疑问]	yiwen	10
        [嘘]	xu	10
        
        [晕]	yun	10
        [衰]	shuai	10
        [骷髅]	kulou	10
        [敲打]	qiaoda	10
        [再见]	zaijian	10
        [擦汗]	cahan	10
        [抠鼻]	koubi	10
        [鼓掌]	guzhang	10
        [坏笑]	huaixiao	10
        [右哼哼]	youhengheng	10
        
        [鄙视]	bishi	10
        [委屈]	weiqu	10
        [快哭了]	kuaikule	10
        [阴险]	yinxian	10
        [亲亲]	qinqin	10
        [可怜]	kelian	10
        [笑脸]	xiaolian	10
        [生病]	shengbing	10
        [脸红]	lianhong	10
        [破涕为笑]	potiweixiao	10
        
        [恐惧]	kongju	10
        [失望]	shiwang	10
        [无语]	wuyu	10
        [嘿哈]	heiha	10
        [捂脸]	wulian	10
        [奸笑]	jianxiao	10
        [机智]	jizhi	10
        [皱眉]	zhoumei	10
        [耶]	ye	10
        [吃瓜]	chigua	10
        
        [加油]	jiayou	10
        [汗]	han	10
        [天啊]	tiana	10
        [Emm]	emm	10
        [社会社会]	shehuishehui	10
        [旺柴]	wangchai	10
        [好的]	haode	10
        [打脸]	dalian	10
        [哇]	wa	10
        [翻白眼]	fanbaiyan	10
        
        [666]	liu	10
        [让我看看]	rangwokankan	10
        [叹气]	tanqi	10
        [苦涩]	kuse	10
        [裂开]	liekai	10
        [嘴唇]	zuichun	10
        [爱心]	aixin	10
        [心碎]	xinsui	10
        [拥抱]	yongbao	10
        [强]	qiang	10
        
        [弱]	ruo	10
        [握手]	woshou	10
        [胜利]	shengli	10
        [抱拳]	baoquan	10
        [勾引]	gouyin	10
        [拳头]	quantou	10
        [OK]	ok	10
        [合十]	heshi	10
        [啤酒]	pijiu	10
        [咖啡]	cafei	10
        
        # Rime dictionary
        # encoding: utf-8
        #
        ---
        name: en_dict_supplement
        version: "2026-10-10"
        sort: by_weight
        ...
        
        [微笑]	wei xiao	10
        [撇嘴]	pie zui	10
        [色]	se	10
        [发呆]	fa dai	10
        [得意]	de yi	10
        [流泪]	liu lei	10
        [害羞]	hai xiu	10
        [闭嘴]	bi zui	10
        [睡]	shui	10
        [大哭]	da ku	10
        
        [尴尬]	gan ga	10
        [发怒]	fa nu	10
        [调皮]	tiao pi	10
        [呲牙]	ci ya	10
        [惊讶]	jing ya	10
        [难过]	nan guo	10
        [囧]	jiong	10
        [抓狂]	zhua kuang	10
        [吐]	tu	10
        [偷笑]	tou xiao	10
        
        [愉快]	yu kuai	10
        [白眼]	bai yan	10
        [傲慢]	ao man	10
        [困]	kun	10
        [惊恐]	jing kong	10
        [憨笑]	han xiao	10
        [悠闲]	you xian	10
        [咒骂]	zhou ma	10
        [疑问]	yi wen	10
        [嘘]	xu	10
        
        [晕]	yun	10
        [衰]	shuai	10
        [骷髅]	ku lou	10
        [敲打]	qiao da	10
        [再见]	zai jian	10
        [擦汗]	ca han	10
        [抠鼻]	kou bi	10
        [鼓掌]	gu zhang	10
        [坏笑]	huai xiao	10
        [右哼哼]	you heng heng	10
        
        [鄙视]	bi shi	10
        [委屈]	wei qu	10
        [快哭了]	kuai ku le	10
        [阴险]	yin xian	10
        [亲亲]	qin qin	10
        [可怜]	ke lian	10
        [笑脸]	xiao lian	10
        [生病]	sheng bing	10
        [脸红]	lian hong	10
        [破涕为笑]	po ti wei xiao	10
        
        [恐惧]	kong ju	10
        [失望]	shi wang	10
        [无语]	wu yu	10
        [嘿哈]	hei ha	10
        [捂脸]	wu lian	10
        [奸笑]	jian xiao	10
        [机智]	ji zhi	10
        [皱眉]	zhou mei	10
        [耶]	ye	10
        [吃瓜]	chi gua	10
        
        [加油]	jia you	10
        [汗]	han	10
        [天啊]	tia na	10
        [Emm]	emm	10
        [社会社会]	she hui she hui	10
        [旺柴]	wang chai	10
        [好的]	hao de	10
        [打脸]	da lian	10
        [哇]	wa	10
        [翻白眼]	fan bai yan	10
        
        [666]	liu	10
        [让我看看]	rang wo kan kan	10
        [叹气]	tan qi	10
        [苦涩]	ku se	10
        [裂开]	lie kai	10
        [嘴唇]	zui chun	10
        [爱心]	ai xin	10
        [心碎]	xin sui	10
        [拥抱]	yong bao	10
        [强]	qiang	10
        
        [弱]	ruo	10
        [握手]	wo shou	10
        [胜利]	sheng li	10
        [抱拳]	bao quan	10
        [勾引]	gou yin	10
        [拳头]	quan tou	10
        [OK]	ok	10
        [合十]	he shi	10
        [啤酒]	pi jiu	10
        [咖啡]	ca fei	10
        

        配置符号直接上屏(GRAVE) #

        因为写 markdown 较多的缘故,所以经常用到`反引号,用来注释重要的内容,中英切换比较费事,所以想不管中英模式,敲`直接上屏。
        如果直接通过补丁的方式覆盖的话, 对于加了commit的值会报错copy on write failed; incompatible node type: commit 参考/issues/504, 所以得直接复制一份共享目录下面的 symbols.yaml 文件到用户目录,并改名为 symbols_updated.yaml。 采用迂回的方式对luna_pinyin.schema.yaml中的 punctuator 直接覆盖。这样既绕过了 commit 的问题,也不用修改原来的 symbols.yaml 文件。

        具体操作如下:
        1).: 修改 symbols_updated.yaml 中的 half_shape 如下图第一个片段。
        正常来说应该已经生效了,但是配置文件中还有其他影响的部分,比如 反查前缀等。所以还需要进行 2,3两步。
        2).: 补丁覆写:reverse_lookup/prefix: ")" ,目前不知道这个反查是什么东西,影响不大。 【反查释义】
        3).: 补丁覆写:recognizer/patterns/reverse_lookup: "R:[a-z]*'?$"。
        4).: 重新部署查看效果。(gif中第一次输入后出现两个`,是 clion 的自动补全效果,后面就正常了)

        配置回车直接上屏 #

        默认的回车操作是上屏 编辑区域的内容,源码可以 参考: editor.cc#L189-L218,相关配置解释可以 参考 Rime_description.md#八其它/第5个
        使回车和空格一样的操作按照如下配置就行。

        具体操作如下:
        1).: 在luna_pinyin.custom.yaml中加入补丁:editor/bindings/Return: confirm。

        取消CTRL触发中西文切换 #

        平常使用 vim 的时候进行模式切换、退出会用到ctrl + [。因为刚开始的错误配置,很容易通过 ctrl 触发 中西文切换,所以用下方补丁调整一下。

        261011更新:
        另外后期使用中发现中英切换的时候,会将刚才输入的码上屏,对于 vim 模式切换极其不友好(切换完之后会将刚才的垃圾字符插入进去)。
        所以切换的时候,清除刚才的输入,配置改变如下高亮第 7 行,对于第 8 行保留功能。
        对于有些文档注释描述中的 Mac 系統上的鼠鬚管不能區分左、右,因此只有對 Shift_L, Control_L 的設定起作用 可能过时了,目前 Mac 环境是可以的。
        代码定义在 ascii_composer.cc 中。

        # encoding: utf-8
        
        patch:
            ascii_composer:
                good_old_caps_lock: true
                switch_key:
                    Shift_L: clear
                    Shift_R: commit_code
                    Control_L: noop         # 调整之前为 commit_code
                    Control_R: noop
                    Caps_Lock: noop
                    Eisu_toggle: noop
        
        • 中英互译 #

          Note

          中英互译和上面的 中英混输 是不一样的,中英混输是增加了英文词典,通过table_translator@english进行映射,产出英文候选词,和中文一并展示在候选项中。
          而现在这个是将候选项进行处理,达到翻译的效果,目前了解到如下两种方式,第一个 opencc 的原理和繁简转换一样,第二个是通过调用 lua 脚本,发出 http 请求,获取翻译文本并展示。

          • Opencc #

            这个流程比较简单,参考 文档1, 文档2 中对 opencc 的配置,对输入的结果进行转换。

            自定义的流程如下:
            1. 在用户配置目录~/Library/Rime/增加 opencc/chinese_english 目录,里面添加文件 chinese_english.json、 chinese_english.txt、 english_chinese.txt。
            2. 在使用方案(当前使用double_pinyin_flypy.schema.yaml)中配置,然后绑定快捷键。

            Caution

            有一个需要注意的点是:如果输入中没有带出候选项,这个转换是不起作用的,因为它是对作用于候选项上的。
            比如英文词典中没有abalone,但是 english_chinese.txt 中有对应条目abalone abalone n.鲍鱼。此时输入abalone,没有候选项,也就不存在转换,没有效果。

            所以提供 AI 味的脚本find_diff.py,用来将 opencc 转换表中的冗余条目写入一个新文件en_dict_supplement.dict.yaml,并入英文主词典。
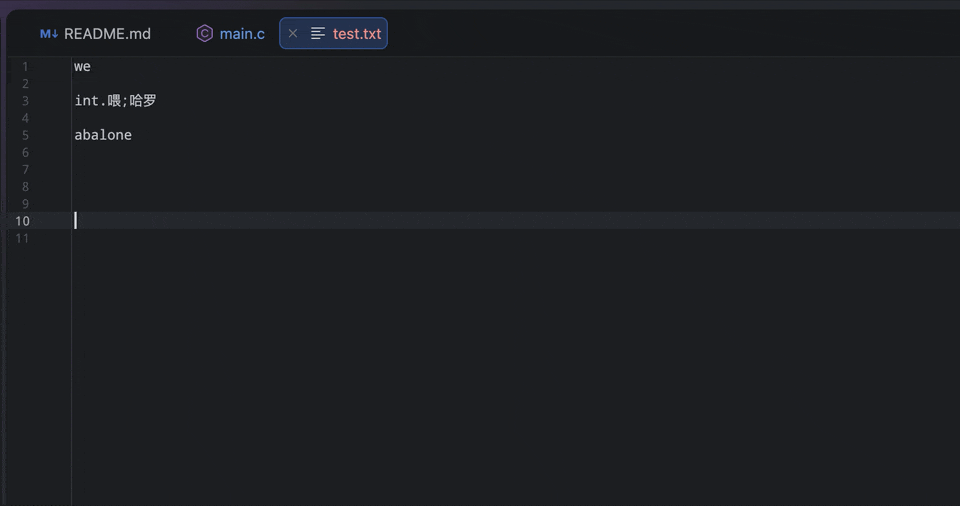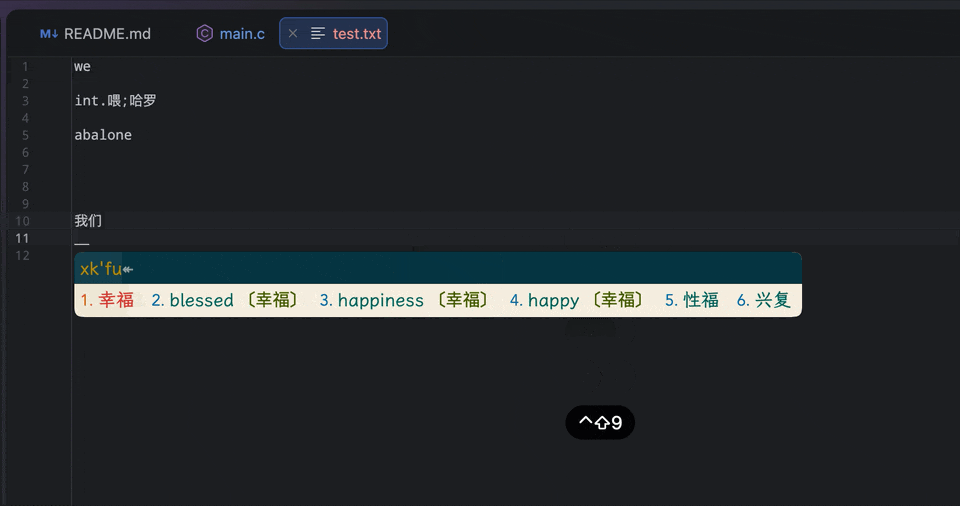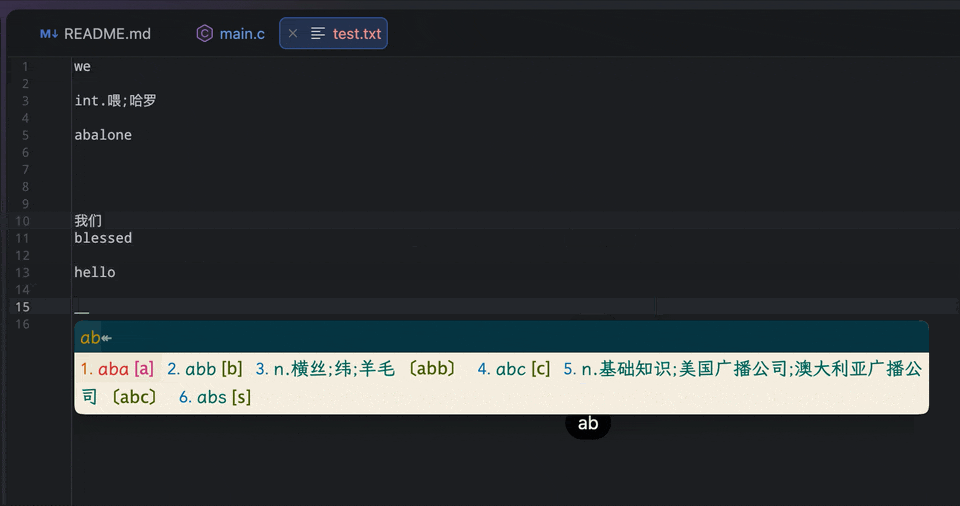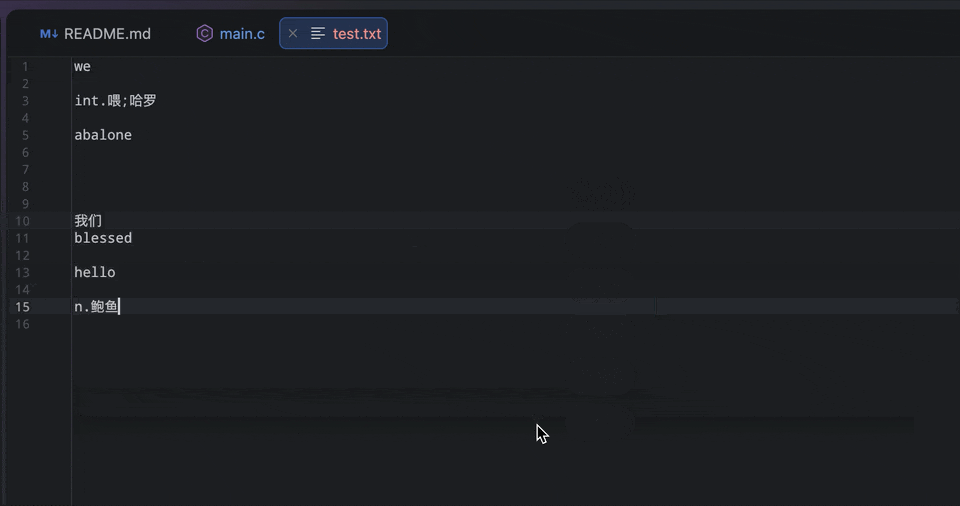
            # 对于中英互译的 opencc 配置
            trans_suggestion:
                option_name: trans_suggestion
                opencc_config: chinese_english/chinese_english.json
                tips: all
                inherit_comment: false
            
            # 将上述配置如繁简转换般引入 filter
            engine:
                filters:
                    - simplifier
                    # - simplifier@emoji_suggestion       # https://www.mintimate.cc/zh/guide/openccEmoji.html
                    - simplifier@trans_suggestion         # https://github.com/gaboolic/rime-shuangpin-fuzhuma/tree/main/opencc
                    - uniquifier
            
            # 增加一个开关控制是否进行转换
            switches:
                - name: ascii_mode
                    reset: 1
                    states: [ 中, A ]
                - name: full_shape
                    states: [ 半角, 全角 ]
                - name: simplification
                    states: [ 漢字, 汉字 ]
                - name: ascii_punct
                    states: [ 。,, ., ]
                # - { name: emoji_suggestion, reset: 1, states: [ "😣️","😁️"] }
                # reset: 0 默认不开启
                - { name: trans_suggestion, reset: 0, states: [ "zh","en"] }
            
            
            # 增加快捷键用来控制开关,此处用的补丁的方式,根据情况自己添加
            patch:
                key_binder/bindings/+:
                # - { when: always, accept: "Control+Shift+8", toggle: emoji_suggestion }
                - { when: always, accept: "Control+Shift+9", toggle: trans_suggestion }
            
            # coding: utf-8
            
            MAIN_DICT = "../dicts/en_dict_primary.dict.yaml"                    # 你的主词典文件(缺少条目的那个)
            TRANS_DICT = "../opencc/chinese_english/english_chinese.txt"        # 你的翻译/英文词典文件(条目齐全的那个)
            OUTPUT_FILE = "../dicts/en_dict_supplement.dict.yaml"               # 提取出来的差异条目存放的新文件
            
            def get_words(file_path):
                words = set()
                with open(file_path, 'r', encoding='utf-8') as f:
                    for line in f:
                        line = line.strip()
                        if not line or line.startswith('#'): # 跳过空行和注释
                            continue
                        # 假设你的词典是用 Tab (\t) 或空格分隔的,取第一个字段作为单词/编码
                        parts = line.split('\t') 
                        if parts:
                            words.add(parts[0].strip())
                return words
            
            def main():
                print("正在读取主词典...")
                main_words = get_words(MAIN_DICT)
            
                print(f"主词典读取完成,共 {len(main_words)} 个独立条目。")
                print("正在对比并提取差异...")
            
                diff_lines = []
                with open(TRANS_DICT, 'r', encoding='utf-8') as f:
                    for line in f:
                        if not line.strip() or line.startswith('#'):
                            continue
                        parts = line.split('\t')
                        word = parts[0].strip()
            
                        # 如果翻译词典里的单词,在主词典里找不到
                        if word not in main_words:
                            diff_lines.append(word + '\t' + word + '\n')
            
                print(f"对比完成!找到 {len(diff_lines)} 个主词典缺失的条目。")
                print("正在写入新文件...")
            
                with open(OUTPUT_FILE, 'w', encoding='utf-8') as f:
                    f.writelines(diff_lines)
            
                print(f"成功!差异条目已保存至: {OUTPUT_FILE}")
            
            if __name__ == "__main__":
                main()
            

          • Lua 请求翻译 API #

            本功能参考了 librime-cloud、 rime-trans,逻辑和代码根据自己的情况适配过。

            目前的大概工作原理是通过 lua 提供的 processor 用来处理按键ctrl + t监听并获取当前选中的候选词,设置标志位,使用 translator 在映射阶段,根据标志位以及选中的候选词进行翻译,产出一个新的候选项,类型是自定的translation。 再次按键ctrl + t 的时候通过context:refresh_non_confirmed_composition()恢复翻译之前的状态,而且这次不作用于它的 translator,因为标志位为 false。

            lua 翻译时需要使用 http 调用 api。应该是没有原生的 http 库,所以有项目封装了一个额外的基于 curl 的简单 simplehttp.so 库,用来在 lua 中发起 http 请求,具体参考 librime-cloud
            虽然名字叫simplehttp.so,但是 MacOS 端实际是 dylib 类型,不影响使用。
            另外我对这个 main.c 进行修改过,导出符号变为luaopen_lua_lib_simplehttp,所以必须放在lua/lib/simplehttp.so 中。外加 curl 的代理功能。
            对于使用,可以参考lua/intfs/wrap_could_api.lua,首先追加库查找路径package.cpath = package.cpath .. ";" .. os.getenv("HOME") .. "/Library/Rime/?.so",然后require("lua.lib.simplehttp")即可。
            需要的可以在这儿下载 simplehttp.so

            这个不只中英,如果翻译 api 支持,其他语言也可以的,调试时使用的 API 是有道的。

            整个目录结构如下
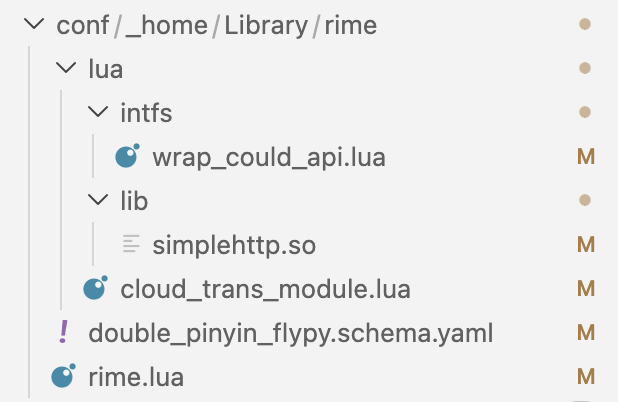

            文件简单解释:
            1. wrap_could_api单词写错了,这个包装了各个厂家的翻译 api,使用simplehttp.so 提供的 http 能力请求数据。
            2. cloud_trans_module.lua定义 processor 和 translator。在 rime.lua 中全局使用,并定义了快捷键。
            3. 在双拼方案中使用即可。

            engine:
                processors:
                    - ascii_composer
                    - recognizer
                    - lua_processor@cloud_pinyin_processor
                    - key_binder
                    - speller
                    - punctuator
                    - selector
                    - navigator
                    - express_editor
                segmentors:
                    - ascii_segmentor
                    - matcher
                    - abc_segmentor
                    - punct_segmentor
                    - fallback_segmentor
                translators:
                    - lua_translator@*date_translator
                    - lua_translator@cloud_pinyin_translator
                    - punct_translator
                    - table_translator@custom_phrase
                    - reverse_lookup_translator
                    - reverse_lookup_translator@radical_reverse_lookup
                    - reverse_lookup_translator@emoji_reverse_lookup
                    - table_translator@english
                    - script_translator
            
            --- 云拼音,Control+t 为云输入触发键
            --- 使用方法:
            --- 将 "lua_translator@cloud_pinyin_translator" 和 "lua_processor@cloud_pinyin_processor"
            --- 分别加到输入方案的 engine/translators 和 engine/processors 中
            --- local cloud_pinyin_provider = require("baidu")
            local cloud_pinyin_provider = require("intfs.wrap_could_api")
            -- local cloud_pinyin_provider = require("sougou")
            local cloud_pinyin = require("cloud_trans_module")("Control+t", cloud_pinyin_provider)
            cloud_pinyin_translator = cloud_pinyin.translator
            cloud_pinyin_processor = cloud_pinyin.processor
            
            local log = require("utils.log")
            -- log.outfile = "/tmp/cloud_trans_module.log"
            
            local function make(trig_key, trig_translator)
            local translated = false
            local origin_selected_cand = nil
            
            log.info("make trigger with key: " .. trig_key)
            
            local function processor(key, env)
                    local kAccepted = 1
                    local kNoop = 2
                    local engine = env.engine
                    local context = engine.context
            
                    -- log.info("press key: " .. key:repr())
            
                    if key:repr() == trig_key then
            
                        origin_selected_cand = context:get_selected_candidate()
            
                        if origin_selected_cand and origin_selected_cand.type == "translation" then
                            context:refresh_non_confirmed_composition()
                            return kAccepted
                        elseif context:is_composing() then
                            translated = true
                            context:refresh_non_confirmed_composition()
                            return kAccepted
                        end
                    end
            
                    return kNoop
            end
            
            local function translator(input, seg, env)
                    -- log.info("translator called with input: " .. input, translated and "translated: " .. tostring(translated))
                    if translated then
                        translated = false
                        local cand = origin_selected_cand
                        if cand and cand.text and cand.text ~= "" then
                            trig_translator(cand.text, seg, env)
                        end
                    end
            end
            
            return { processor = processor, translator = translator }
            end
            
            return make
            
            -- ref: https://github.com/3q-u/rime-trans/blob/master/lua/input_text.lua
            local home = os.getenv("HOME")
            package.cpath = package.cpath .. ";" .. home .. "/Library/Rime/?.so"
            
            local log = require("utils.log")
            local json = require("utils.json")
            local sha = require("utils.sha2")
            local http = require("lua.lib.simplehttp")
            -- 全局 HTTP 超时(秒),避免网络不通时卡住引擎线程
            http.TIMEOUT = 1.5 
            http.PROXY = "http://127.0.0.1:7890"    -- simplehttp.so 重新编译新增的选项
            
            -- 翻译API配置
            local config = {
                -- 选择使用的翻译API: "google", "deepl", "microsoft", "deeplx", "niutrans", "youdao", "baidu" 
                -- 百度翻译暂时不可用,请勿使用
                default_api = "youdao",
            
                -- API密钥配置
                api_keys = {
                    deepl = "YOUR_DEEPL_API_KEY", -- DeepL API密钥
                    microsoft = {
                        key = "YOUR_MS_TRANSLATOR_API_KEY", -- Microsoft Translator API密钥
                        region = "global" -- 替换为您的区域
                    },
                    niutrans = "YOUR_NIUTRANS_API_KEY", -- 小牛云翻译API密钥
                    youdao = {
                        app_id = "", -- 有道翻译应用ID
                        app_key = "" -- 有道翻译应用密钥
                    },
                    baidu = {
                        app_id = "YOUR_BAIDU_APP_ID", -- 百度翻译应用ID
                        app_key = "YOUR_BAIDU_APP_KEY" -- 百度翻译应用密钥
                    }
                }
            }
            
            -- URL编码函数
            local function url_encode(str)
                if str then
                    str = string.gsub(str, "\n", "\r\n")
                    str = string.gsub(str, "([^%w %-%_%.%~])",
                        function(c)
                            return string.format("%%%02X", string.byte(c))
                        end)
                    str = string.gsub(str, " ", "+")
                end
                return str
            end
            
            local function is_chinese_character(input)
                if not input or #input == 0 then return false end
                local last_codepoint = nil
                for _, codepoint in utf8.codes(input) do last_codepoint = codepoint end
                if last_codepoint >= 19968 and last_codepoint <= 40959 then return true end
                return false
            end
            
            -- Google翻译API
            local function google(text)
                local encoded_text = url_encode(text)
                local url = "https://translate.googleapis.com/translate_a/single?client=gtx&sl=zh-CN&tl=en&dt=t&dt=bd&dt=rm&dt=qca&dt=at&dt=ss&dt=md&dt=ld&dt=ex&dj=1&q=" .. encoded_text
            
                log.info("google start: " .. url)
                local t0 = os.time()
                local reply = http.request(url)
                local dt = os.difftime(os.time(), t0)
                local rlen = reply and #reply or -1
                log.info(string.format("google done: len=%d dt=%ds", rlen, dt))
                local success, j = pcall(json.decode, reply)
            
                if success and j then
                    if j.dict and j.dict[1] and j.dict[1].terms and j.dict[1].terms[1] then
                        return j.dict[1].terms[1]
                    end
                    if j.sentences and j.sentences[1] and j.sentences[1].trans then
                        return j.sentences[1].trans
                    end
                end
            
                if reply then
                    local _, _, terms = string.find(reply, '"terms":%[%"([^"]+)"')
                    if terms then
                        return terms
                    end
            
                    local _, _, translated = string.find(reply, '"trans":"([^"]+)"')
                    if translated then
                        return translated
                    end
            
                    local _, _, translated2 = string.find(reply, '%[%[%["([^"]+)"')
                    if translated2 then
                        return translated2
                    end
                end
            
                return nil
            end
            
            -- DeepL翻译API
            local function deepl(text)
                local api_key = config.api_keys.deepl
                if not api_key then
                    return nil
                end
            
                local url = "https://api-free.deepl.com/v2/translate"
                local body = "auth_key=" .. api_key .. "&text=" .. url_encode(text) .. "&target_lang=EN"
            
                local headers = {
                    ["Content-Type"] = "application/x-www-form-urlencoded"
                }
            
                local reply = http.request{
                    url = url,
                    method = "POST",
                    headers = headers,
                    data = body
                }
                local success, j = pcall(json.decode, reply)
            
                if success and j and j.translations and j.translations[1] and j.translations[1].text then
                    return j.translations[1].text
                end
            
                return nil
            end
            
            -- Microsoft翻译API
            local function microsoft(text)
                local api_key = config.api_keys.microsoft.key
                local region = config.api_keys.microsoft.region
            
                if not api_key then
                    return nil
                end
            
                local url = "https://api.cognitive.microsofttranslator.com/translate?api-version=3.0&to=en"
                local body = json.encode({
                    {["Text"] = text}
                })
            
                local headers = {
                    ["Content-Type"] = "application/json",
                    ["Ocp-Apim-Subscription-Key"] = api_key,
                    ["Ocp-Apim-Subscription-Region"] = region
                }
            
                local reply = http.request{
                    url = url,
                    method = "POST",
                    headers = headers,
                    data = body
                }
                local success, j = pcall(json.decode, reply)
            
                if success and j and j[1] and j[1].translations and j[1].translations[1] and j[1].translations[1].text then
                    return j[1].translations[1].text
                end
            
                return nil
            end
            
            -- 小牛云翻译API
            local function niutrans(text)
                local api_key = config.api_keys.niutrans
                if not api_key then
                    return nil
                end
            
                local url = "https://api.niutrans.com/NiuTransServer/translation"
            
                local body = json.encode({
                    from = "zh",
                    to = "en",
                    apikey = api_key,
                    src_text = text
                })
            
                local headers = {
                    ["Content-Type"] = "application/json"
                }
            
                local reply = http.request{
                    url = url,
                    method = "POST",
                    headers = headers,
                    data = body
                }
            
                if not reply or reply == "" then
                    return nil
                end
            
                local success, j = pcall(json.decode, reply)
                if not success then
                    return nil
                end
            
                if j.tgt_text then
                    if type(j.tgt_text) == "string" then
                        local inner_success, inner_json = pcall(json.decode, j.tgt_text)
                        if inner_success and type(inner_json) == "table" then
                            return inner_json.content
                        else
                            return j.tgt_text
                        end
                    elseif type(j.tgt_text) == "table" then
                        if j.tgt_text.content then
                            return j.tgt_text.content
                        else
                            for k, v in pairs(j.tgt_text) do
                                if type(v) == "string" then
                                    return v
                                end
                            end
                            return nil
                        end
                    else
                        return nil
                    end
                elseif j.translation then
                    return j.translation
                elseif j.result and j.result.translatedText then
                    return j.result.translatedText
                else
                    return nil
                end
            end
            
            -- 有道翻译API
            -- https://ai.youdao.com/DOCSIRMA/html/trans/api/wbfy/index.html#接口调用参数
            local function youdao(text)
                local app_id = config.api_keys.youdao.app_id
                local app_key = config.api_keys.youdao.app_key
            
                if not app_id or not app_key then
                    log.error("有道API密钥未配置")
                    return nil
                end
            
                local salt = tostring(math.random(32768, 65536))
                local curtime = tostring(os.time())
                local sign_str = app_id .. text .. salt .. curtime .. app_key
                local sign = sha.sha256(sign_str)
                local form_to = is_chinese_character(text) and "&from=zh-CHS&to=en" or "&from=auto"
            
                local url = "https://openapi.youdao.com/api"
                local body = "q=" .. text
                    .. form_to
                    .. "&appKey=" .. app_id
                    .. "&salt=" .. salt
                    .. "&sign=" .. sign
                    .. "&signType=v3"
                    .. "&curtime=" .. curtime
            
                local headers = {
                    ["Content-Type"] = "application/x-www-form-urlencoded"
                }
            
                -- log.info("有道翻译请求URL: " .. url)
                -- log.info("有道翻译请求体: " .. body)
            
                local reply = http.request{
                    url = url,
                    method = "POST",
                    headers = headers,
                    data = body
                }
            
                if not reply or reply == "" then
                    log.error("有道翻译收到空响应")
                    return nil
                end
            
                -- log.info("有道翻译响应: " .. reply)
            
                local success, j = pcall(json.decode, reply)
                if not success then
                    log.error("有道翻译JSON解析失败: " .. tostring(j))
                    return nil
                end
            
                if j and j.translation and j.translation[1] then
                    -- log.info("有道翻译结果: " .. tostring(j.translation[1]))
                    return j.translation[1]
                elseif j and j.basic and j.basic.explains and j.basic.explains[1] then
                    log.info("有道翻译basic.explains: " .. tostring(j.basic.explains[1]))
                    return j.basic.explains[1]
                else
                    log.error("有道翻译未找到有效结果")
                    return nil
                end
            end
            
            -- 百度翻译API
            local function baidu(text)
                local app_id = config.api_keys.baidu.app_id
                local app_key = config.api_keys.baidu.app_key
            
                if not app_id or not app_key then
                    log.error("百度API密钥未配置")
                    return nil
                end
            
                local salt = tostring(math.random(32768, 65536))
                local sign = sha.md5(app_id .. text .. salt .. app_key):lower()
            
                local url = "https://fanyi-api.baidu.com/api/trans/vip/translate"
                local body = "q=" .. url_encode(text)
                    .. "&from=zh&to=en"
                    .. "&appid=" .. app_id
                    .. "&salt=" .. salt
                    .. "&sign=" .. sign
            
                local headers = {
                    ["Content-Type"] = "application/x-www-form-urlencoded"
                }
            
                log.info("百度翻译请求URL: " .. url)
                log.info("百度翻译请求体: " .. body)
            
                local reply = http.request{
                    url = url,
                    method = "POST",
                    headers = headers,
                    data = body
                }
            
                if not reply or reply == "" then
                    log.error("百度翻译收到空响应")
                    return nil
                end
            
                log.info("百度翻译响应: " .. reply)
            
                local success, j = pcall(json.decode, reply)
                if not success then
                    log.error("百度翻译JSON解析失败: " .. tostring(j))
                    return nil
                end
            
                if j and j.trans_result and j.trans_result[1] and j.trans_result[1].dst then
                    log.info("百度翻译结果: " .. tostring(j.trans_result[1].dst))
                    return j.trans_result[1].dst
                else
                    log.error("百度翻译未找到有效结果")
                    return nil
                end
            end
            
            local function trans(text)
                local result
            
                if config.default_api == "google" then
                    result = google(text)
                elseif config.default_api == "deepl" then
                    result = deepl(text)
                elseif config.default_api == "microsoft" then
                    result = microsoft(text)
                elseif config.default_api == "niutrans" then
                    result = niutrans(text)
                elseif config.default_api == "youdao" then
                    result = youdao(text)
                elseif config.default_api == "baidu" then
                    result = baidu(text)
                else
                    result = google(text)
                end
            
                return result
            end
            
            local function do_translator(text, seg, env)
            
                -- log.info("translator called with input: " .. input .. ", content: " .. content)
                -- local t0 = os.time()
            
                local translated_text = trans(text)
                -- local dt = os.difftime(os.time(), t0)
                -- log.info(string.format("trans end dt=%ds ok=%s", dt, tostring(translated_text ~= nil)))
            
                if translated_text then
                    local c = Candidate("translation", seg.start, seg.start + string.len(translated_text), translated_text, "〘译〙")
                    c.quality = 2
                    -- c.preedit = env.engine.context:get_preedit().text
                    yield(c)
                end
            end
            
            return do_translator
            

            Caution

            需要注意目前有时候翻译出来的候选项插入不到最前面,二次ctrl+t取消之前得通过左右按键先选中翻译项。

      • 小鹤双拼 #

      • Rime引擎 #

        版本:[2024/09/29]:https://github.com/rime/librime/tree/aaaaaec344c22c1b3b8059190a00e4c532a2ab54

        • 源码处理参考 #

          Tip

          engine 中的所有模块组合 gears_module.cc
          engine 中对于按键的处理流程 ConcreteEngine::ProcessKey
          engine 中处理器processor中 fluid_editor/fluency_editor 和 express_editor 的处理 异同

        • 编译与调试 #

          Note

          由于需要查看 yaml 文件生成后到底是什么样的,以及配置了为什么没有生效等问题。所以将源代码拉取下来,进行分析,结合日志打印出的信息以及 AIGC 等问答,最后修改 librime 输入法引擎部分代码,实现测试,验证等效果。
          上述部分可以使用更方便的方式查看,在后续学习中发现的。其实在用户目录下的 ~/Library/Rime/build 目录就包含完整(补丁后)的方案 yaml 以及编译好的词典文件。

          修改的commit为: aaaaaec3
          编译参考文档: Rime with Mac
          文件变更: feat: add yaml dump to temp dir for test and verify.

        • 各种bin文件解析 #

          使用 java 对项目中使用到的各种 bin 文件进行解析,参考 代码

        • 用户习惯数据探索 #

          在使用以及学习的过程中,发现在~/Library/Rime配置路径下面存在一些以 userdb 结尾的目录,应该就是用户数据目录了,用来保存输入习惯,符合 leveldb 形式。所以就用 leveldb-viewer来确认里面到底是什么。

          以普朗特为例,目前用户习惯里面是没有的,先拷贝一份为 example.userdb。查看里面是否存在pu lang te,通过 esc 聚焦到输入框,然后键入。
          没有的情况下,输入普朗特,让 rime 记录一下,然后重新拷贝,这时候就发现里面已经出现了,enter 可以展示 value 值在右侧。

          Warning

          另外 leveldb 数据库中的数据在 sync 目录有 tsv 类型的 txt 数据备份,可以直接查看,而且通过托盘 同步用户数据 按钮可以将这些文件可以恢复成数据库形式。
          两者是合并关系,不用担心覆盖清空的情况(不过验证的时候最好备份一下)。

        • 指定 Lua 依赖库编译 #

          Comment

          在很长一段时间之后没有使用 brew 更新过系统依赖,直到最近在使用 three.js 绘画 3D 的时候发现 npm 需要的 node 的版本号得 >= 18,以致于安装了最新的,进而牵一发动全身,莫名的 Lua 版本也跟着从 5.4.6 更新到了 5.5.0。然后启动输入法就报错了Symbol not found: _luaL_openlibs。

          现在就有两种解决办法,第一,lua 版本回退回去,也就是我目前使用的。第二种就是使用现有的 5.5.0 版本重新编译 rime 库。两种都尝试过。下面简单记录一下过程。

          顺带一提:rime 的插件库是可以通过BUILD_MERGED_PLUGINS选项选择和主库进行合并的,也就是生成一个 librime.1.11.2.dylib,或者单独生成。squirrel 里面就是使用的单独生成,可以看到单独的依赖库在/Library/Input Methods/Squirrel.app/Contents/Frameworks/rime-plugins下面。

          第二种没什么好说的,直接修改plugins/lua/CMakeLists.txt里面的版本,让 cmake 重新构建,完事儿后从新编译替换就行。但是有个问题,5.5.0版本的 lua 由于安全考虑,不允许在 for 循环里面修改迭代变量,也就是需要修改 lua 脚本,目前不好调试,另外有好几个需要修改的,也就放弃了。

          • Lua 版本降级 #

            由于是 brew 安装的,好像直接给系统链接最新的,而且也不太好链接老版本,所以只能通过修改plugins/lua/CMakeLists.txt单独给 rime 指定版本。如下主要代码。

            然后就是重新编译,其他错误可以把刚才构建的缓存删了,重新 cmake 构建,然后编译 rime 和 rime-lua 就可以生成 librime.1.11.2.dylib,librime-lua.dylib。然后替换,部署就行。

            另外还可以通过 otool 工具查看刚才编译出来的 librime-lua.dylib 里面所依赖的 lua 相关路径,是不是所希望的指定位置。如下图

            # 由于5.4版本的位置在 /usr/local/opt/lua@5.4,所以配置到 pkg-config 搜索路径里面。
            set(LUA_VERSION "lua" CACHE STRING "lua version")
            set(ENV{PKG_CONFIG_PATH} "/usr/local/opt/lua@5.4/lib/pkgconfig:$ENV{PKG_CONFIG_PATH}")
            if(NOT EXISTS "${CMAKE_CURRENT_SOURCE_DIR}/thirdparty/lua5.4/lua.h")
            find_package(PkgConfig)
            if(PkgConfig_FOUND)
                foreach(pkg ${LUA_VERSION} lua5.4 lua53 lua52 luajit lua51)
                pkg_check_modules(LUA IMPORTED_TARGET GLOBAL ${pkg})
                if(LUA_FOUND)
                break()
                endif()
                endforeach()
            endif()
            if(LUA_FOUND)
                set(LUA_TARGET PkgConfig::LUA)
                include_directories(${LUA_INCLUDE_DIRS})
            else()
                message(FATAL_ERROR "Lua not found, consider using `bash action-install.sh` to download.")
            endif()
            else()
            

      • 其他 #

        Caution

        1).: 在计算机科学和编程中,grave 通常指的是“重音符”或“倒尖号”,在键盘上通常位于数字 1 键的左边,形状像一个倾斜的撇号,有时也被称为反引号 `。 — 来自阿里通义
        2).: space理解为空格,这个算是基本常识了、但是backspace一度懵逼,后来一查,发现是退格键。😝

    • Reference #


    comments powered by Disqus